توزیع مقادیر حدی تعمیم یافته – به زبان ساده
در توزیعهای احتمالی و آمار، توزیع مقادیر حدی (Extreme Value Distribution) و توزیع مقادیر حدی تعمیم یافته (Generalized Extreme Value Distribution)، خانوادهای از توزیعهای پیوسته محسوب میشوند که با نظریه مقادیر حدی (Extreme Value Theory) مرتبط هستند. در این نوشتار به معرفی توزیع مقادیر حدی و تعمیم آن میپردازیم و خصوصیاتش را مورد بررسی قرار میدهیم.



توزیع مقادیر حدی تعمیم یافته
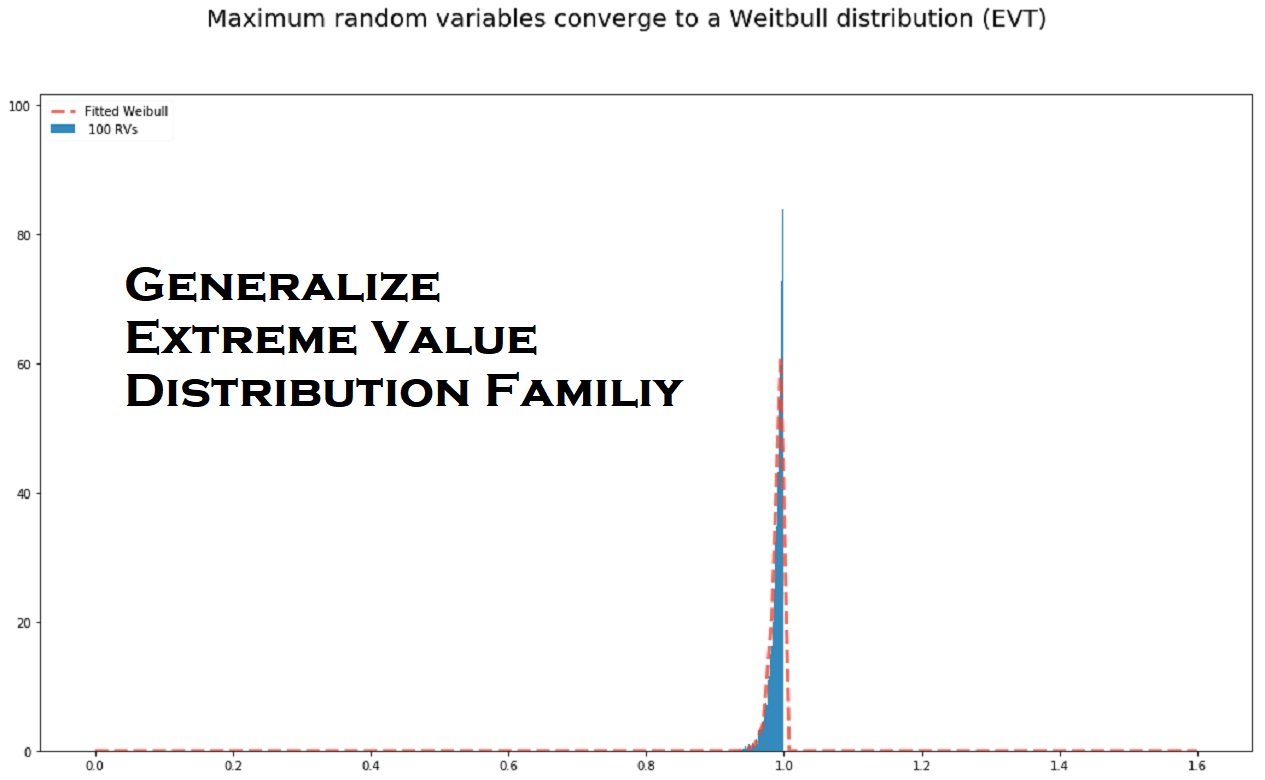
در نظریه آمار و احتمال، توزیع «مقادیر حدی تعمیم یافته» (Generalize Extreme Value) که به طور خلاصه با GEV نشان داده میشود، خانوادهای از توزیعهایی است که مرتبط با نظریه مقدارهای حدی است. در این خانواده از توزیعها سعی شده است که برای توزیعهای گامبل (Gumbel)، فِرِشه (Frechet) و وایبل (Weibull) به عنوان توزیعهای مقادیر حدی، ساختار یکسانی ایجاد شود.
بهتر است ابتدا در مورد قضیه مقادیر حدی (کرانگین ) توضیحات بیشتری داده سپس در مورد توزیع این مقادیر صحبت کنیم.
نظریه مقادیر حدی (کرانگین)
توزیع مقادیر تصادفی که به ندرت رخ میدهند، موضوع مورد بحث در نظریه مقادیر حدی (EVT) یا Extreme Value Theory است. نظریه مقادیر حدی، شاخهای از آمار است که برای مدلبندی و شناخت پدیدههایی است که مرتبط با پیشامدهای نادر و غیرطبیعی بوده و سعی دارد برای آنها یک مدل احتمالی ارائه دهد.
قضیه مقادیر حدی اولین بار توسط دانشمند بزرگ آمار رنالد فیشر (Ronald Fisher) و «لئونارد تیپت» (Leonard Tippett) در اوایل قرن بیستم مورد بررسی قرار گرفت. تیپت به عنوان مسئول کنترل کیفیت یک کارخانه نخ ریسی مشغول بررسی میزان مقاومت نخها بود.

تحقیقاتی که تیپت روی مقاومت پارچههای پنبهای انجام داد، نشان داد که میزان مقاومت نخهای پنبهای وابسته به ضعیفترین تارهای آنها است. بعدها به کمک نظریه پردازیهای فیشر، او توانست با کمک روشهای آماری، توزیع مقادیر حدی را پایهریزی کند. در ادامه کارهای او، گامبل، توزیع گامبل را با نام خودش تعمیم داد.
به صورت رسمی این قضیه به صورت زیر در حالت تک متغیره بیان میشود.
فرض کنید دنبالهای متناهی از متغیرهای تصادفی مستقل و هم توزیع باشند که همگی دارای تابع توزیع تجمعی هستند. در این صورت اگر باشد، آنگاه
اگر از توزیع اطلاع نداشته باشیم، طبقه قضیه «فیشر-تیپت-گندنکو» (Fisher–Tippett–Gnedenko theorem) میتوان یک توزیع مجانبی یا حدی برای پیدا کرد.
توزیع مقادیر حدی، قضیه فیشر-تیپت-گندنکو
اگر دنبالهای از مقادیر و وجود داشته باشد که رابطه زیر برقرار باشد:
آنگاه میتوان نشان داد که تابع به شکل زیر نوشته خواهد شد.
به این شکل، توزیعهای وایبل، گامبل و فرچه را میتوان به صورت زیر بازنویسی کرد.
توزیع وایبل:
$$\large {\displaystyle G(z)={\begin{cases}\exp \left\{-\left(-\left({\frac {z-b}{a}}\right)\right)^{\alpha }\right\}&z<b\\1&z\geq b\end{cases}}}$$مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید